英伟达、AMD和定制ASIC的出货预期,最终要经过电网、发电设备、审批和并网能力的约束;约380GW的远期用电需求,真正难点集中在2027—2028年的供电缺口。
一、AI估值的物理底座从芯片变成电力
市场通常先看英伟达、AMD和定制ASIC的出货量、售价与毛利率,但远期算力能否兑现,还要回答一个更基础的问题:每一块芯片能不能获得稳定电力并持续运行。报告把芯片出货量换算成数据中心用电需求,提出到2030年约380GW的用电情景。
这个数字不是电网已经承诺的订单,也不是确定的全球统计,而是建立在芯片出货、机架功耗、PUE和部署节奏上的模型结果。估值中如果默认“造出的芯片都能插上电”,就会忽略从制造到上线之间的基础设施时间差。
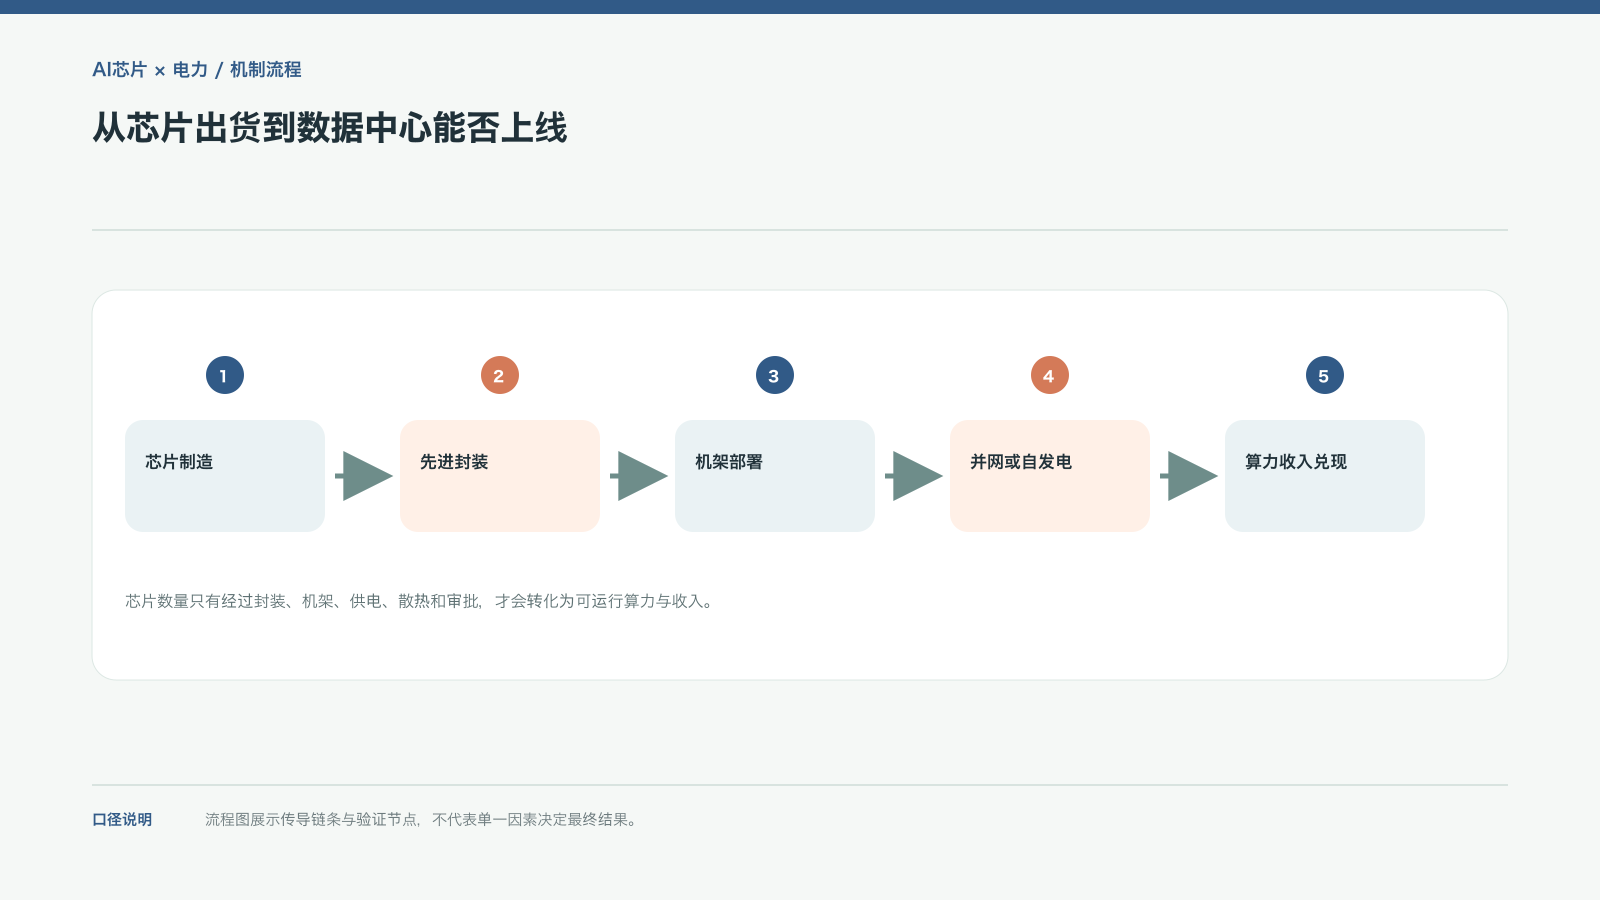
电力约束会通过上线时间传导到收入确认。芯片已交付但机房尚未通电时,客户可能先支付设备款,也可能延后验收;即使服务器已经运行,电力不稳定还会降低利用率,令每瓦特对应的有效算力低于名义参数。
二、英伟达、AMD与ASIC的电力账本并不相同
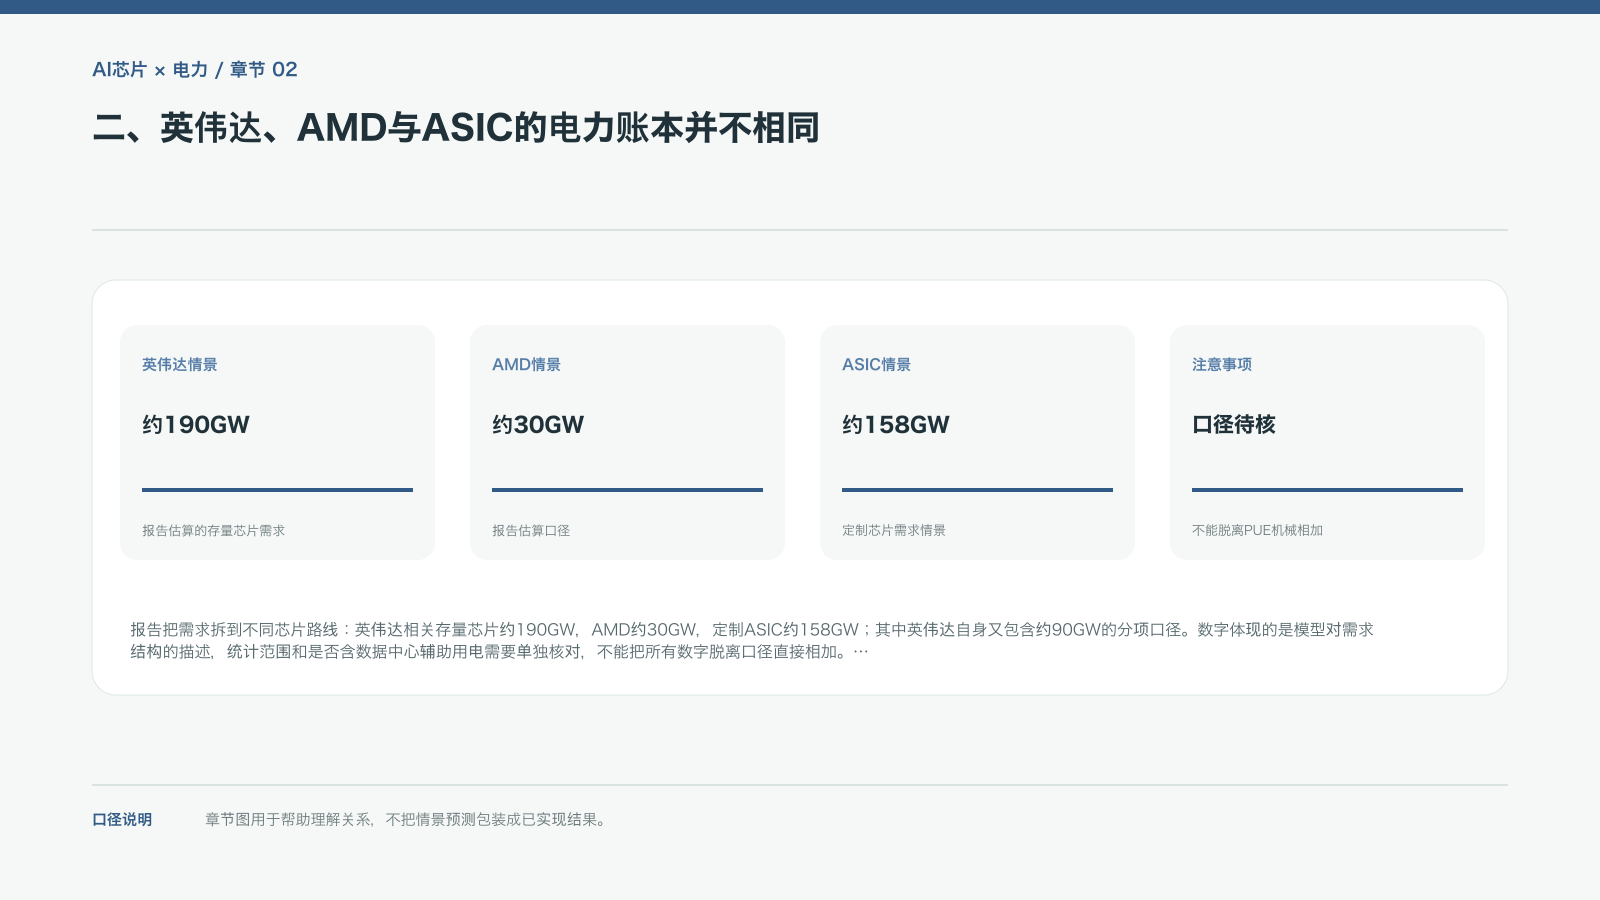
报告把需求拆到不同芯片路线:英伟达相关存量芯片约190GW,AMD约30GW,定制ASIC约158GW;其中英伟达自身又包含约90GW的分项口径。数字体现的是模型对需求结构的描述,统计范围和是否含数据中心辅助用电需要单独核对,不能把所有数字脱离口径直接相加。
ASIC的耗电占比被预测从2026年的约35%升至2030年的约45%,但按芯片收入计算约占30%。定制芯片适合固定工作负载,通用GPU则拥有更广泛的软件生态和更高的系统价值。未来竞争不只是谁的算力更强,也是谁能在有限电力下交付更高收入。
英伟达、AMD和ASIC的比较不能只看芯片热设计功耗,还要看整机、网络、存储和备用电源的系统功耗。定制ASIC可能在固定任务上更高效,通用GPU则在模型变化时拥有更强的复用能力,客户会用工作负载和交付周期共同决定采购结构。
三、高密度机架减少数量,却抬高电力和散热难度
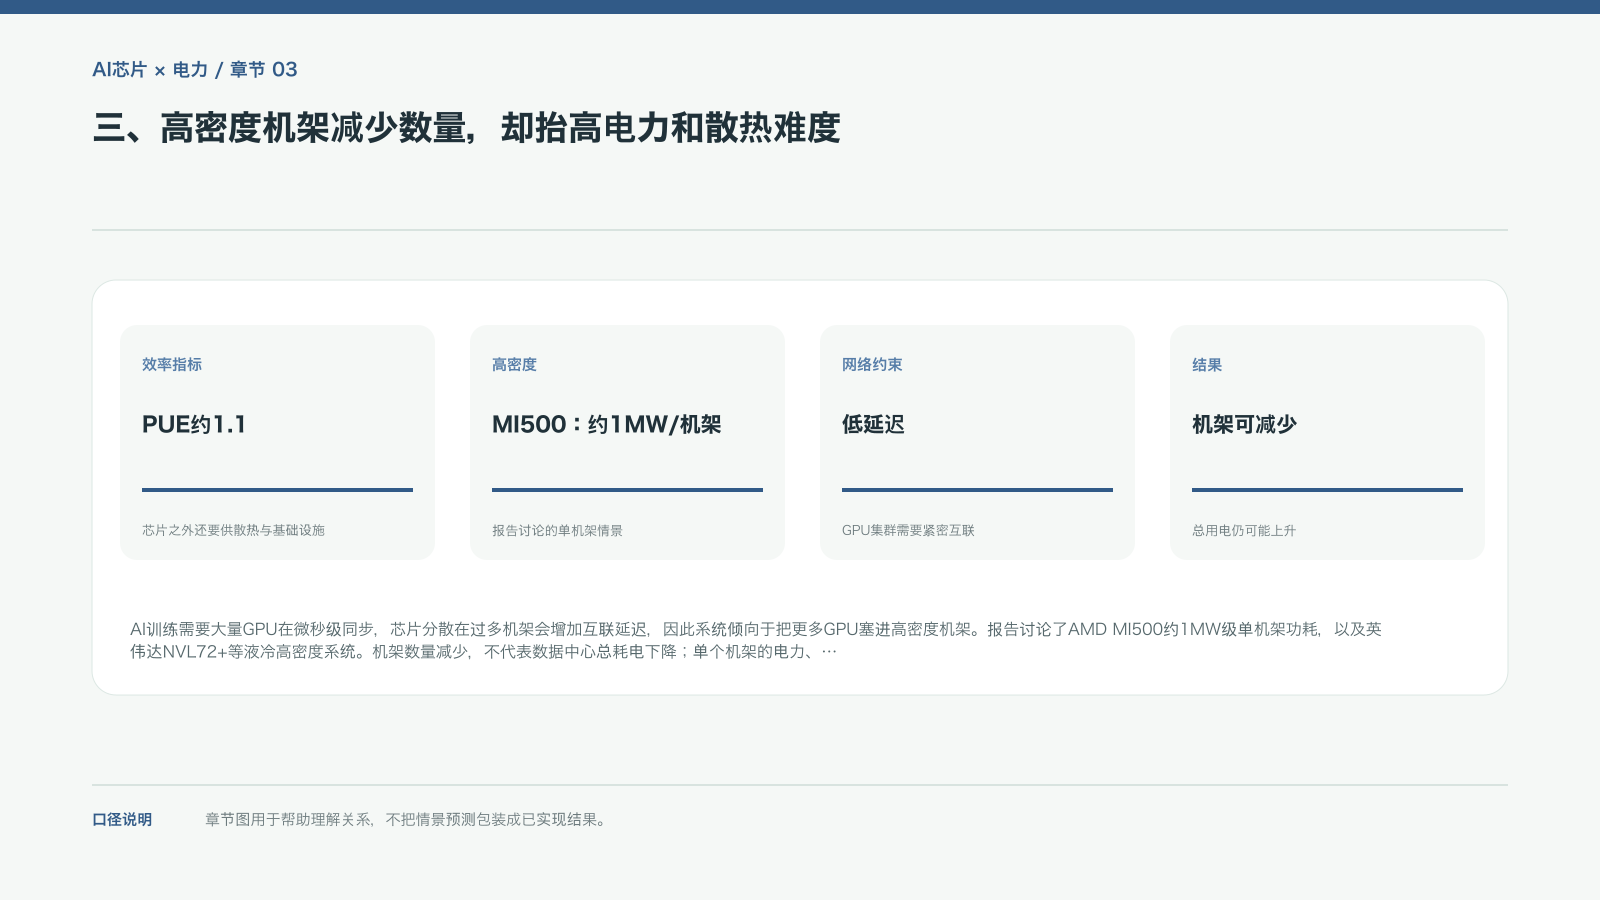
AI训练需要大量GPU在微秒级同步,芯片分散在过多机架会增加互联延迟,因此系统倾向于把更多GPU塞进高密度机架。报告讨论了AMD MI500约1MW级单机架功耗,以及英伟达NVL72+等液冷高密度系统。机架数量减少,不代表数据中心总耗电下降;单个机架的电力、散热、供电冗余和配电密度都在提高。
PUE约1.1意味着每向芯片提供1瓦,还要为冷却和基础设施额外消耗约0.1瓦。看似很小的比例,乘以数百GW后就会变成大型能源项目。芯片性能、光互联、液冷和电力设计必须作为同一个系统衡量。
液冷、高速互联和更高机架密度并非单独的技术升级。它们会同时改变机房地板承重、冷却水路、配电柜、网络拓扑和维护方式。某一项性能提升只有在整套基础设施同步到位时,才会表现为更高的集群利用率。
四、415GW潜在供给里,真正能落地的部分更少
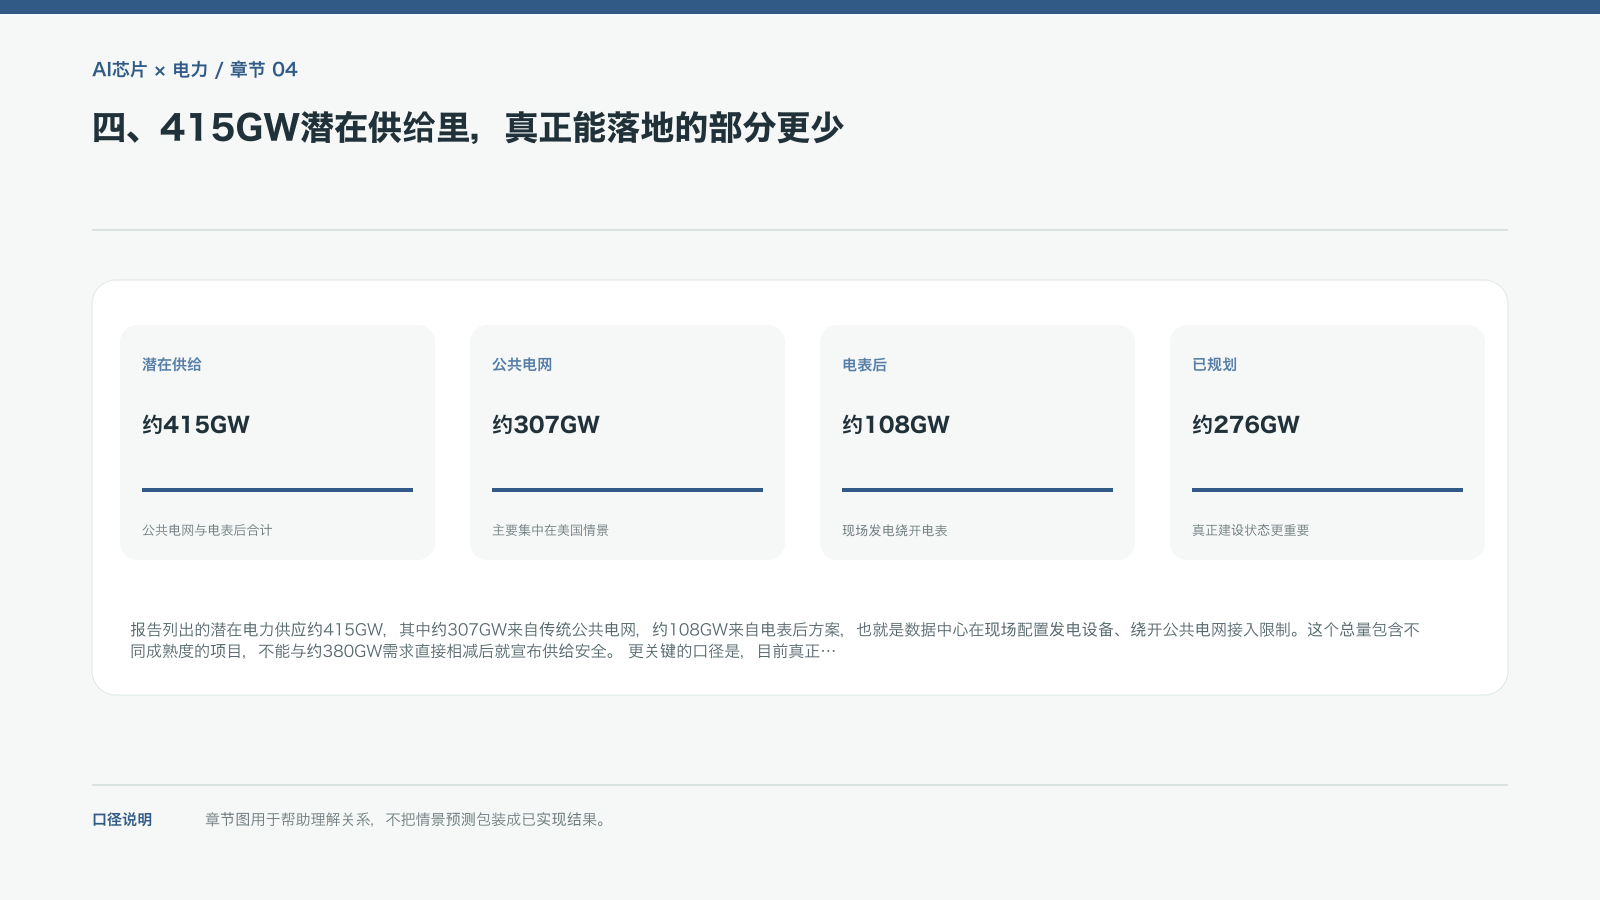
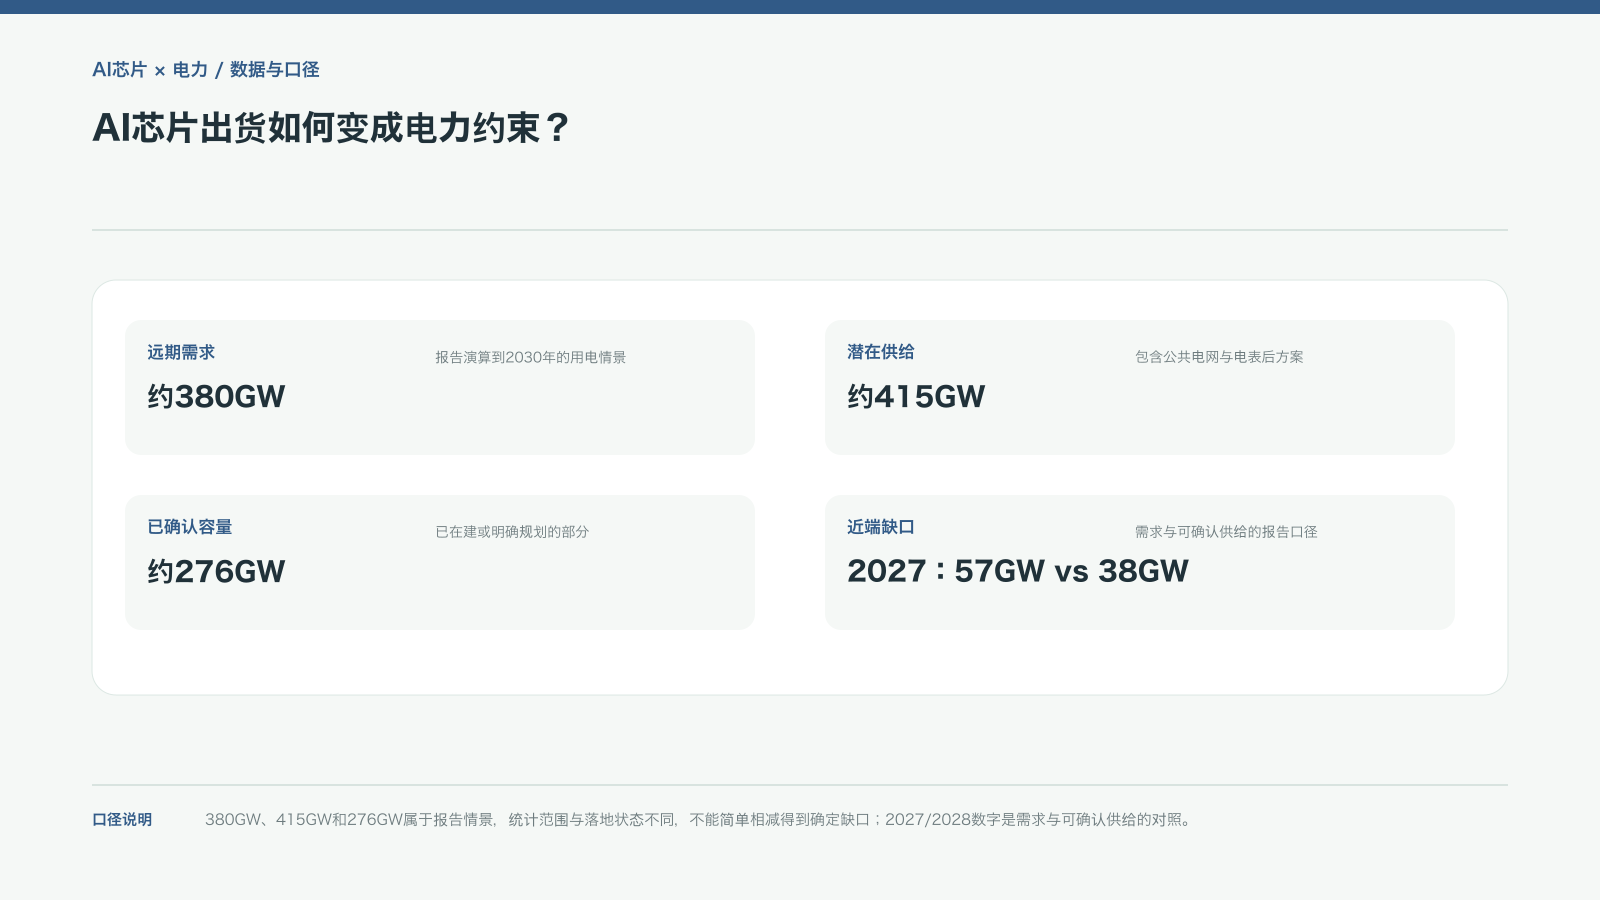
报告列出的潜在电力供应约415GW,其中约307GW来自传统公共电网,约108GW来自电表后方案,也就是数据中心在现场配置发电设备、绕开公共电网接入限制。这个总量包含不同成熟度的项目,不能与约380GW需求直接相减后就宣布供给安全。
更关键的口径是,目前真正处于在建或已明确规划状态的数据中心容量约276GW,剩余部分可能只是宣布项目、早期图纸或尚未完成审批的发电厂。潜在供给只有转化为土地、设备、燃料、输电线路和并网许可,才具有交付意义。
潜在供给与可确认供给之间的差距,本质上是项目成熟度差距。土地、变压器、燃气轮机、输电线路和许可证任何一项延期,都会把名义容量留在表格里,无法支持实际机架。投资判断应优先看已获批、已开工和已签设备订单的项目。
五、2027—2028是远期平衡表中的真空期
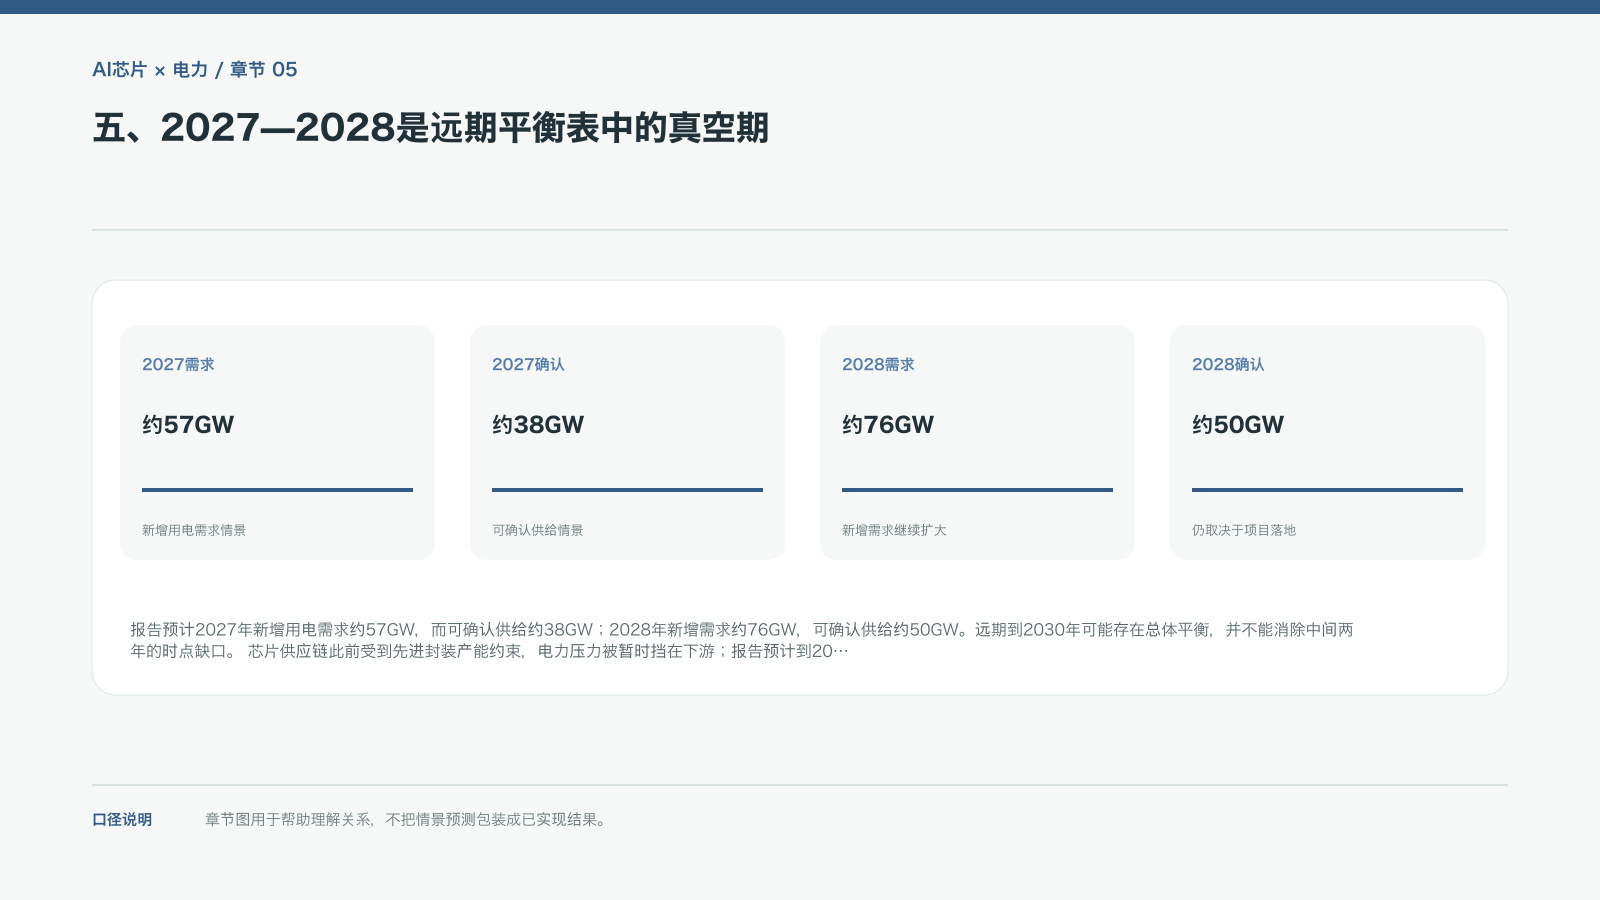
报告预计2027年新增用电需求约57GW,而可确认供给约38GW;2028年新增需求约76GW,可确认供给约50GW。远期到2030年可能存在总体平衡,并不能消除中间两年的时点缺口。
芯片供应链此前受到先进封装产能约束,电力压力被暂时挡在下游;报告预计到2027年底,CoWoS产能可能达到每月约27万片,制造端瓶颈缓解后,芯片会更快进入云厂商数据中心,供电就从后台条件变成收入兑现的硬约束。封装线可以在较短时间扩张,电厂、变电站和高压线往往需要多年。
2027和2028的缺口还可能表现为区域错配:有电力的地区未必有网络和客户,有芯片需求的地区又可能缺少并网容量。跨区域迁移需要新的光纤、土地和延迟预算,不能假定所有GW都可以在全球范围自由调度。
六、电表后发电是缓冲,不是无条件的第二电网
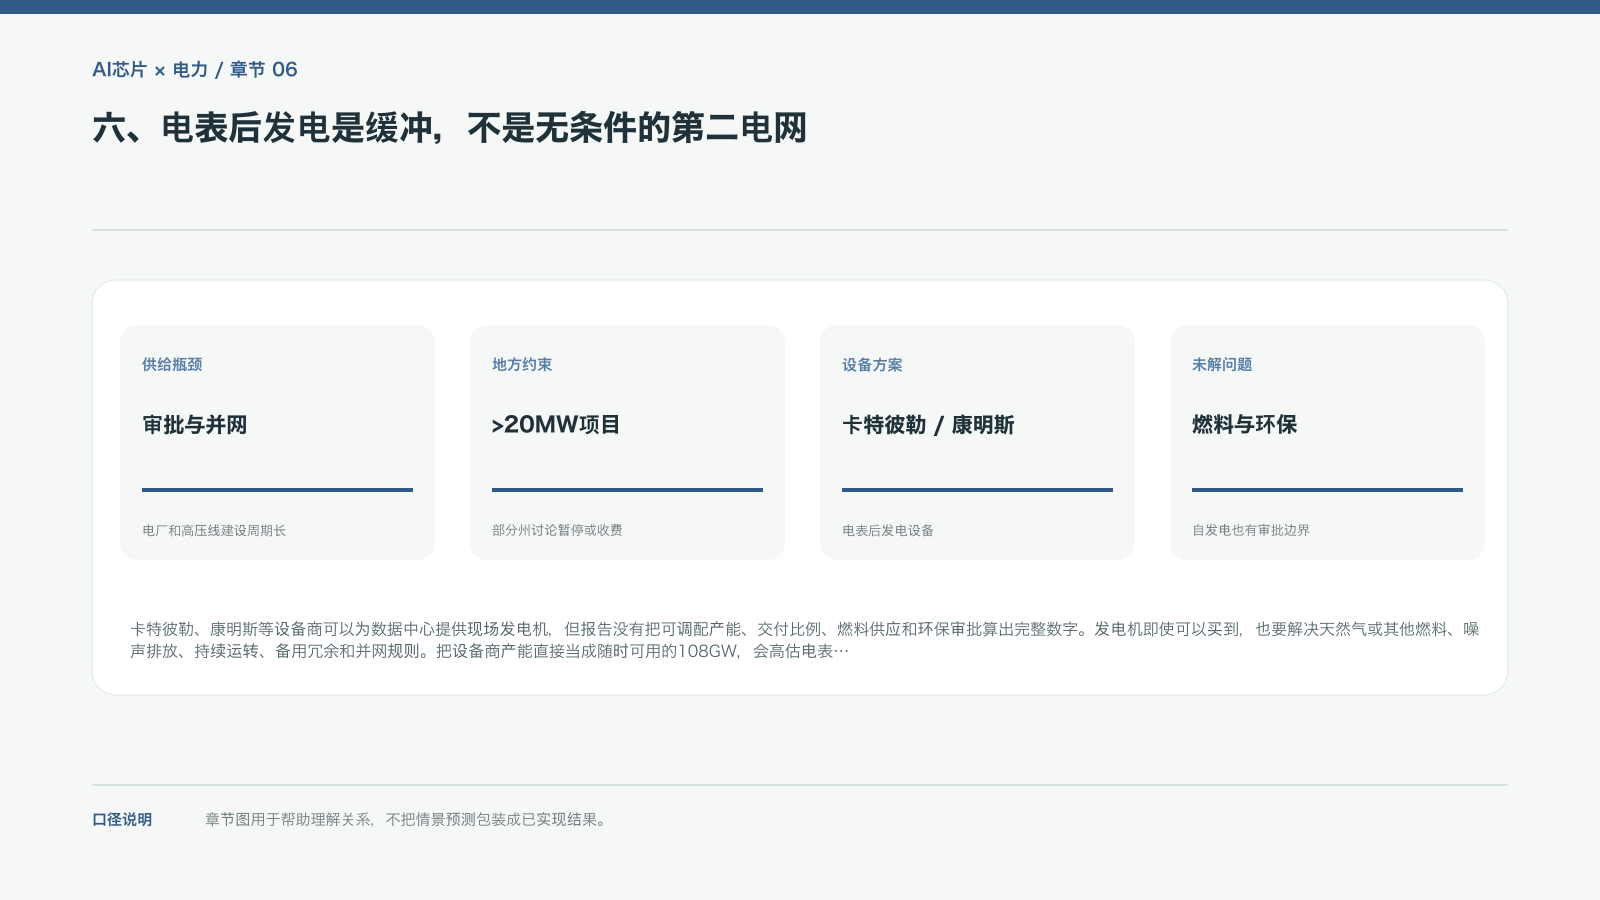
卡特彼勒、康明斯等设备商可以为数据中心提供现场发电机,但报告没有把可调配产能、交付比例、燃料供应和环保审批算出完整数字。发电机即使可以买到,也要解决天然气或其他燃料、噪声排放、持续运转、备用冗余和并网规则。把设备商产能直接当成随时可用的108GW,会高估电表后方案的确定性。
美国部分州已经讨论对大型数据中心设置暂停、延迟并网、收取电网升级费用或要求签署长期合同。20MW以上项目的审批变化,会直接影响大型算力集群的上线时间和总拥有成本。自发电能缓解接入瓶颈,但不能跳过地方监管和基础设施建设。
电表后方案的经济性取决于燃料价格、发电机利用小时、排放许可和备用电源要求。它更像一个把上线时间提前的缓冲层,而不是成本完全相同的公共电网替代品;一旦长期运行,燃料和维护费用会直接进入数据中心的总拥有成本。
七、三个信号决定AI芯片收入能否穿过电力瓶颈
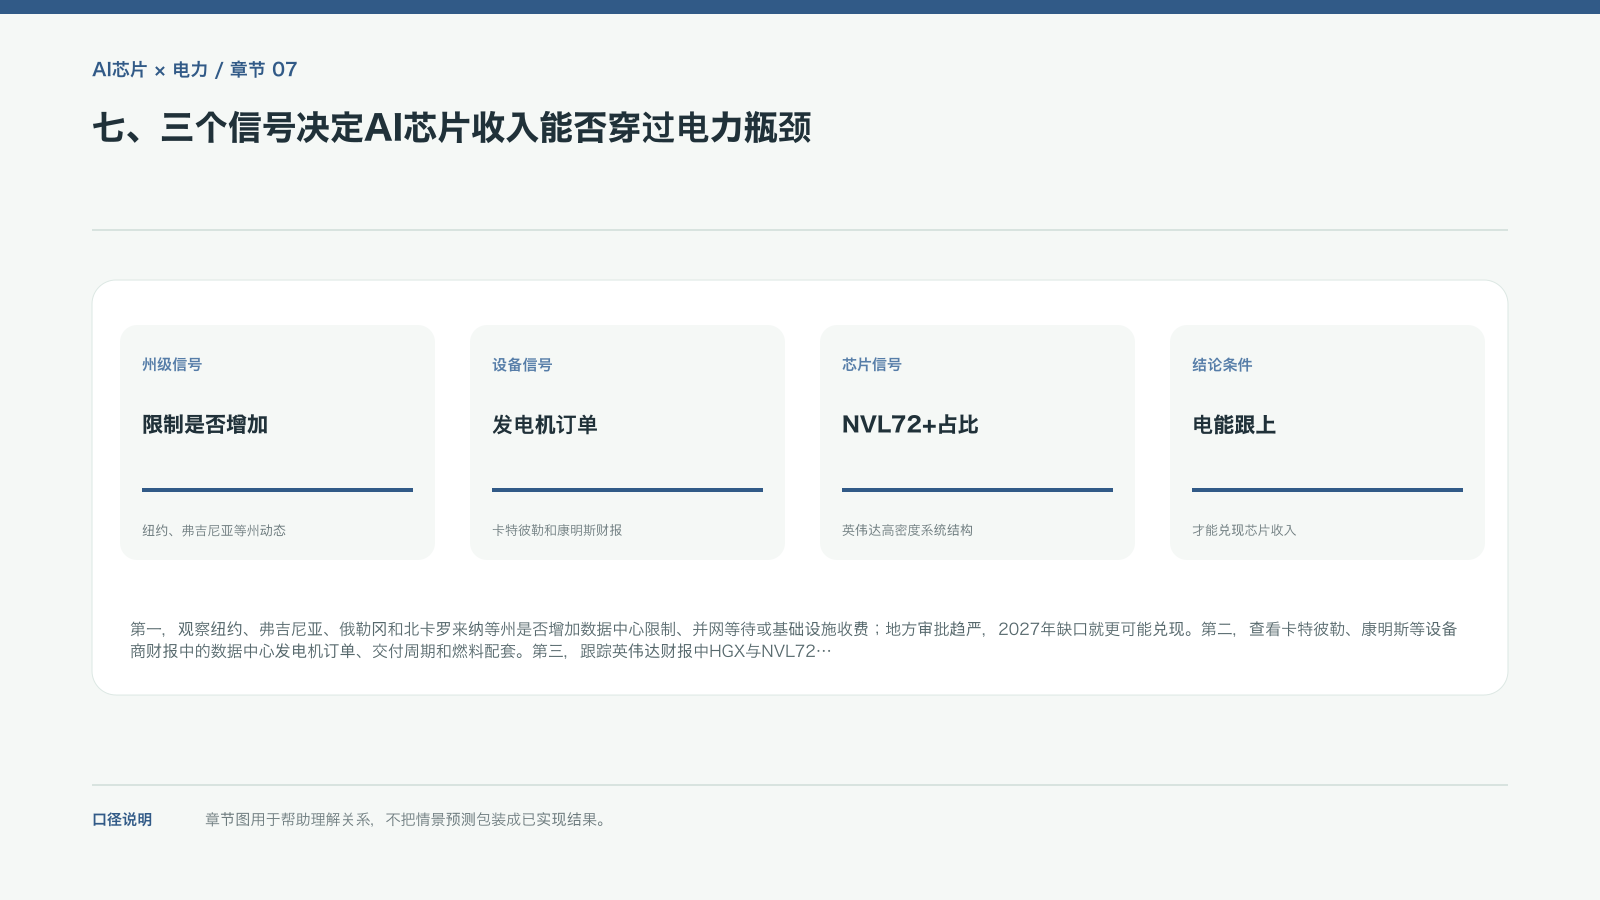
第一,观察纽约、弗吉尼亚、俄勒冈和北卡罗来纳等州是否增加数据中心限制、并网等待或基础设施收费;地方审批趋严,2027年缺口就更可能兑现。第二,查看卡特彼勒、康明斯等设备商财报中的数据中心发电机订单、交付周期和燃料配套。第三,跟踪英伟达财报中HGX与NVL72+等高密度系统的出货结构,高密度系统占比上升,说明单位电力带来的收入可能提高,但前提仍是有电可用。
如果电网项目落地率远低于模型假设,电表后设备无法及时交付,或者AI应用变现不足导致云厂商削减资本开支,380GW远期需求就需要下修。AI芯片的下一个竞争点,不只在晶圆和封装,也在土地、电力、燃料和并网许可。
验证时应把芯片订单、云厂商资本开支、电力项目开工和发电设备交付放在同一时间轴上。若芯片出货继续上升但电力项目不动,收入兑现会延后;若供电顺利而客户削减资本开支,供给宽松也不能保证算力需求继续增长。
因此,英伟达和AMD的出货判断不能停留在加速卡数量,AI产业链的交付约束已经延伸到变电站、冷却系统、发电设备和地方许可。约380GW是需求情景,不是自动兑现的收入;只有芯片、机架、电力和客户应用在同一时间表上完成,远期算力账本才会从模型变成经营结果。
这也意味着供应链分析要从单一公司扩展到项目链条:芯片订单对应多少机架,机架对应多少电力,电力对应什么并网时间,最终又对应多少可计费算力。每一步都有延迟和损耗,任何一项被高估,都会让总需求看起来比可兑现收入更大。 这能把“需求很大”与“需求可以按时交付”区分开,也更接近英伟达、AMD及基础设施供应商真实面对的经营约束。尤其要注意,供给数字必须按照项目成熟度和投产时间折算,不能把尚未获批的容量当作当年的可用电力。